
 简体中文
 English
KNOWLEDGE ARTICLE
robots.txt 是什么?
爬虫访问规则
告诉合规爬虫哪些路径允许或不允许抓取。
核心解释
robots.txt 位于网站根目录,主要控制抓取,不等同于禁止索引,也不是访问权限或安全机制。
robots.txt 是什么
robots.txt 是放在网站根目录的纯文本文件,用于告诉遵守 Robots Exclusion Protocol 的爬虫哪些路径可以抓取。它按 User-agent 分组,并使用 Allow、Disallow 与 Sitemap 等字段表达站点级抓取规则。
该文件主要管理抓取资源的方式,不是登录权限,也不是隐藏敏感内容的安全措施。公开互联网中的任何人通常都能访问 robots.txt,因此不适合在里面列出本应保密的地址。
robots.txt 如何参与抓取
- 爬虫访问站点前通常先请求根目录下的 /robots.txt,并识别适用于自身 User-agent 的规则组。
- Allow 与 Disallow 会按路径匹配规则决定哪些 URL 可以请求;不同爬虫对非标准扩展的支持可能不同。
- Sitemap 字段可以提供一个或多个网站地图地址,帮助爬虫继续发现规范页面。
- 文件不可访问、语法冲突或缓存未刷新时,具体处理方式由爬虫规范和平台策略决定。
常见规则与使用场景
站点常用 robots.txt 限制站内搜索结果、无限筛选参数、重复资源或不适合搜索抓取的技术路径。需要公开收录的重要页面及其 CSS、JavaScript 和图片资源通常应保持可抓取,以便搜索引擎正常渲染。
大型网站可以为不同爬虫设置独立规则,但规则越复杂,误封的概率通常越高。每次模板、目录结构或域名迁移后,都适合重新核对主要爬虫分组和 Sitemap 声明。
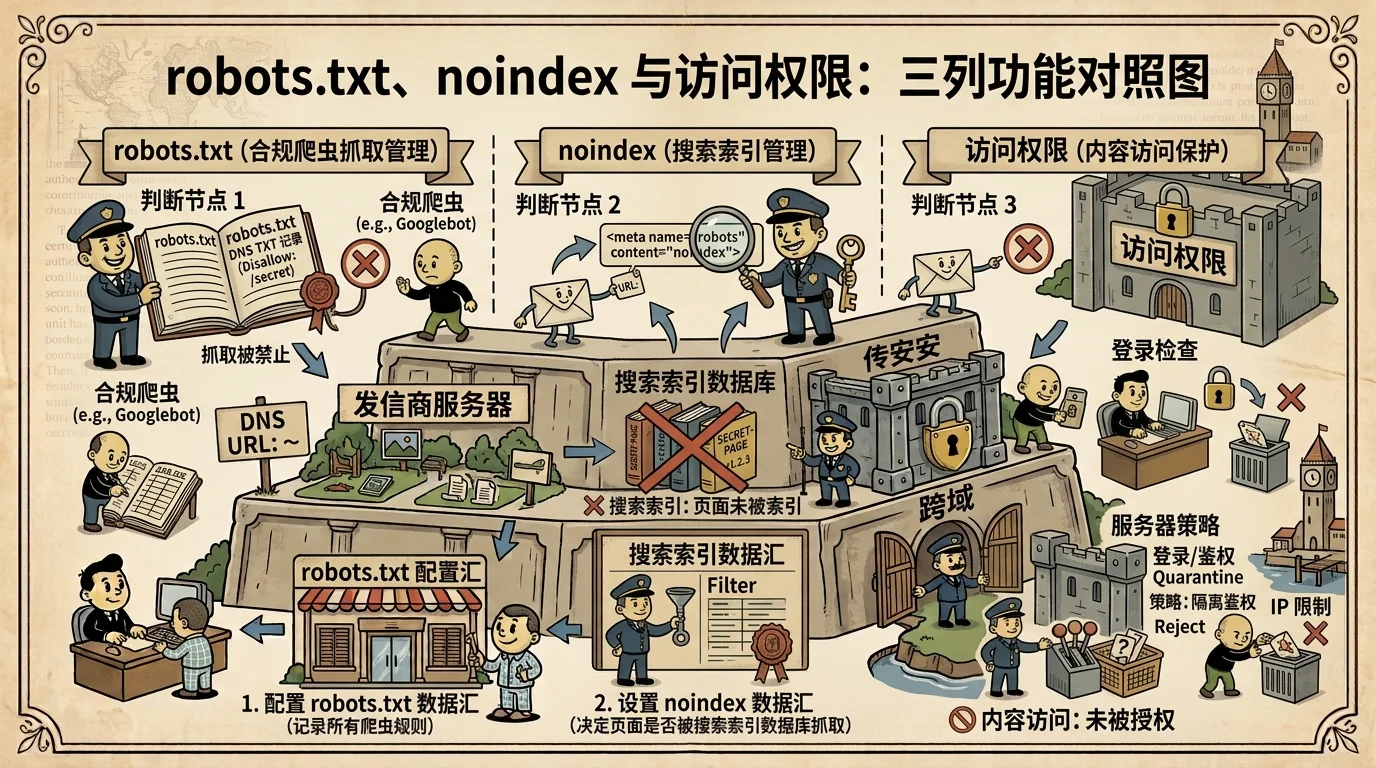
抓取、索引与访问权限有什么区别
抓取是搜索引擎请求页面内容,索引是搜索引擎决定是否把页面加入可检索数据库,访问权限则由网站登录、鉴权和服务器规则控制。robots.txt 主要作用于第一步。
如果页面已经被其他链接发现,即使禁止抓取,搜索结果中仍可能出现 URL。希望页面不进入索引时通常使用 noindex,并确保爬虫能够访问页面读取该指令;真正敏感内容则应使用可靠的访问控制。
实际应用与信息解读
明确的 Allow、Disallow 和 Sitemap 可以直接作为配置事实展示。规则的最终影响需要结合 User-agent、目标路径、HTTP 状态和页面级索引指令判断,因此更适合说明“可能影响哪些路径”,而不是直接断言页面一定不会被收录。
文件内容不可取得时,robots.txt 状态应显示未知;只有确认请求成功并完整解析后,才适合统计规则数量和具体允许、禁止范围。
重点关注
误封重要资源会影响抓取;仅靠 robots.txt 隐藏敏感地址也可能暴露路径。
常见问题
robots.txt 可以阻止页面出现在搜索结果中吗?
它主要阻止合规爬虫抓取,不保证 URL 一定不出现在搜索结果。控制索引通常使用 noindex;保护敏感内容应使用登录或服务器权限。
robots.txt 中的 Disallow 会保护隐私吗?
不会。robots.txt 通常公开可见,Disallow 只是面向合规爬虫的抓取规则,不能阻止用户或其他程序直接访问 URL。
可以在 robots.txt 中声明多个 Sitemap 吗?
可以。每个 Sitemap 字段可提供一个完整地址,网站也可以使用 Sitemap Index 管理大量地图文件。