
 简体中文
 English
KNOWLEDGE ARTICLE
X-Robots-Tag 是什么?
HTTP 索引控制标头
通过 HTTP 响应标头向搜索引擎提供索引与展示指令。
核心解释
X-Robots-Tag 可用于 HTML,也可用于 PDF、图片等没有 HTML meta 标签的资源。常见值包括 noindex、nofollow 和 nosnippet。
X-Robots-Tag 如何控制非 HTML 资源索引
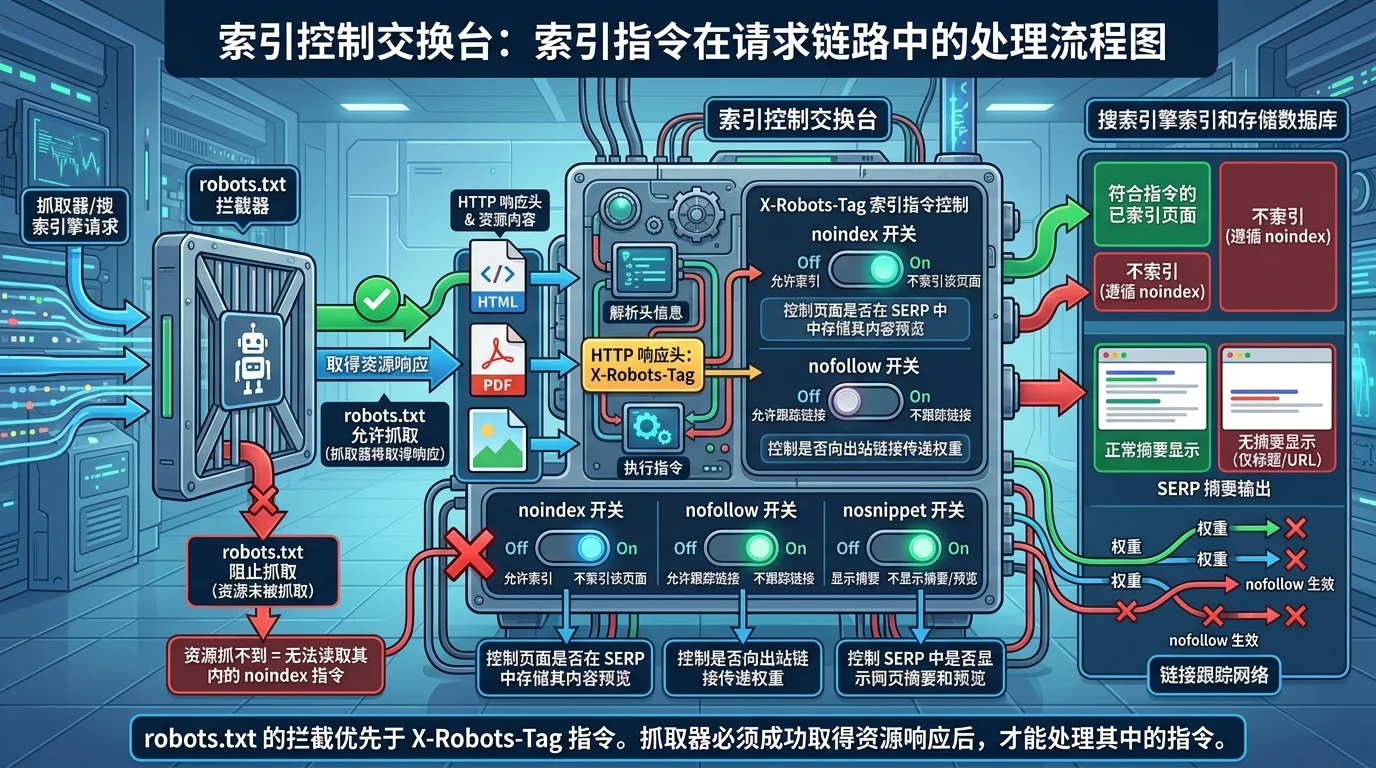
X-Robots-Tag 是 HTTP 响应标头,可向搜索引擎发送 noindex、nofollow、nosnippet、noarchive 等索引与展示指令。它既能用于 HTML,也能控制 PDF、图片、文档和其他没有 HTML head 的资源,是服务器层批量治理的重要方式。
标头可以面向所有支持的爬虫,也可带特定 user-agent 前缀。多个指令可以分行或组合返回;搜索引擎需要先抓取资源才能读取标头,因此被 robots.txt 完全禁止抓取的 URL 可能无法让 noindex 生效。
索引指令在请求链路中何时被读取
- 爬虫请求 URL 并取得最终响应,检查状态码、X-Robots-Tag 与 HTML meta robots,然后决定索引和展示处理。
- 重定向中间响应和最终目标可能拥有不同指令,实际索引通常更关注最终可抓取资源与规范信号。
- 服务器或 CDN 可按路径、文件类型和环境统一增加标头,配置范围过宽时可能让整个目录意外 noindex。
- 搜索平台重新抓取前仍可能保留旧状态,移除 noindex 后恢复也需要等待抓取与重新处理。
批量规则为何既强大又容易误伤
对下载附件、测试环境、站内搜索和私有导出文件,服务器规则可以避免逐页修改。但反向代理、对象存储或 CDN 若使用模糊路径匹配,可能把 noindex 加到正式文章、图片或 Sitemap。
上线应抽样检查不同文件类型、状态码和主机,并监控搜索平台报告。访问控制和 noindex 仍需分开:后者只是请求搜索引擎不索引,不能保护敏感内容不被访问。
实际应用与信息解读
明确返回的 X-Robots-Tag 可以直接展示,并解释它可能影响索引或摘要的范围。是否已经退出搜索结果取决于爬虫支持、重新抓取和其他信号,不应由一个标头推断即时结果。
首页未出现该标头不代表其他文件没有。只有按目标资源检查后才能说明其状态;无法取得响应时应显示未知。
重点关注
错误的 noindex 可能让资源退出索引;是否生效仍取决于爬虫能否抓取该 URL 并识别指令。
常见问题
X-Robots-Tag 与 meta robots 有什么区别?
语义相近,但 X-Robots-Tag 位于 HTTP 标头,可用于 PDF、图片等非 HTML 资源,也方便服务器批量配置。
robots.txt 禁止抓取后 noindex 会生效吗?
搜索引擎若无法抓取资源,就可能读不到 noindex。希望移除索引时通常应允许抓取并返回 noindex。
noindex 能保护私密文件吗?
不能。它是搜索索引指令,真正敏感内容需要认证和服务器访问权限。