
 简体中文
 English
AI 生成的网站测评
AI 生成本测评由 AI 根据公开资料生成,未经逐项人工核实;域名、证书等事实以本页采集数据为准。
TokenVerse是什么网站?
TokenVerse 是一个展示多概念个性化图像生成研究项目的网站,来自 Google DeepMind 与多所高校的合作研究,论文发表于 SIGGRAPH 2025 并获最佳论文奖。
用途
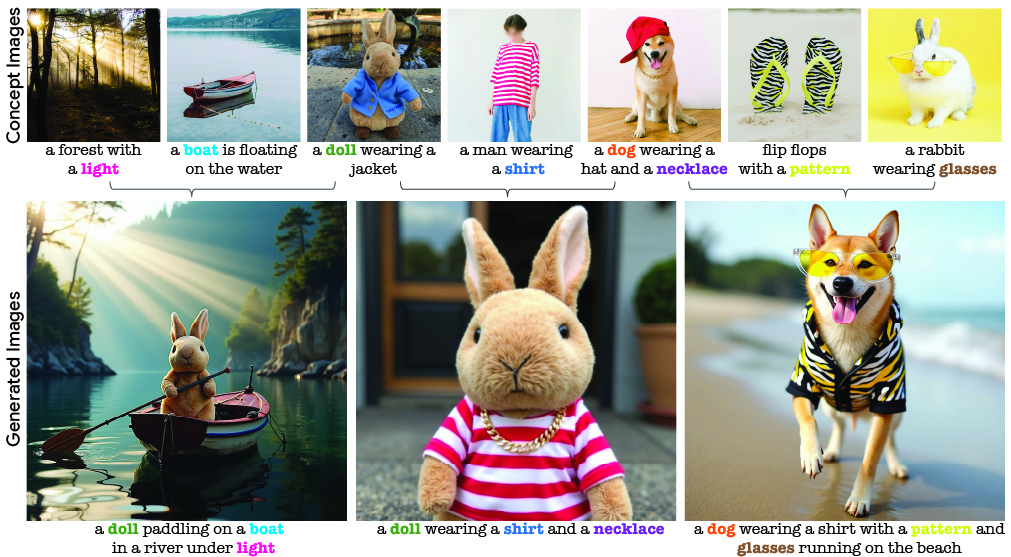
它介绍的方法能从单张图片中分离出复杂视觉元素和属性,再把来自多张图片的多个概念自由组合生成新图像。支持的概念范围较广,包括物体、配饰、材质、姿态和光照等。
适用场景
- 想把不同图片里的元素“拆”出来再拼到一张新图里,例如把娃娃、衬衫、眼镜、项链分别从不同图片提取后组合到海滩场景。
- 需要同时处理多个概念、且每个概念来自不同图片的个性化生成任务。
- 研究或了解基于 DiT 文本到图像模型的个性化方法。
网站上能做什么
页面提供摘要、结果展示、方法说明和 BibTeX 引用信息,还有一个“Try Me”交互演示:点击提示词中被高亮的词(如 Doll、Shirt、Glasses、Necklace)即可选择概念,观察组合生成效果。代码标注为“coming soon”,暂未开放。
选择条件
如果你关注的是学术方法本身或想引用该论文,这个页面合适;如果只想直接拿来做生产工具,目前还缺少可下载的代码或在线服务。
TokenVerse如何从单张图片中提取多个概念并组合生成新图像?
TokenVerse 的做法不是把整张图“记住”后整体套用,而是把每个概念拆成文本词在调制空间中的独立方向,再按新提示词组合这些方向生成图像。据页面资料,它利用 DiT 文本到图像模型中“调制”对生成的影响,在给定一张图和一段文字描述后,为每个词寻找一个独立的调制方向;这些方向随后可用于把学到的概念按目标配置组合成新图。
具体流程
| 步骤 | 做什么 | 对应用途 |
|---|---|---|
| 1. 输入概念图与描述 | 提供一张包含多个元素的图片,并给出文字描述 | 让模型知道图里有哪些可分离的概念 |
| 2. 找词级方向 | 在调制空间中为每个词优化出独立方向 | 把“娃娃、衬衫、眼镜、项链”等拆开,而不是混成一个整体 |
| 3. 组合生成 | 用新的提示词选择并组合这些方向 | 生成“娃娃戴眼镜和项链在海滩”这类新配置 |
适合的使用场景
例如需要从一张搭配图中分别保留“衬衫”“眼镜”“项链”,再换到另一个主体或场景里,TokenVerse 的用途就是把配件、材质、姿态、光照等概念单独抽出来重组。页面列出的支持范围包括物体、配饰、材质、姿态和光照,并且可以处理多张图、每张图含多个概念的情况。
选择条件
如果你要的是“单图多概念拆分 + 跨图组合”,它比只能处理单一物体或概念范围较窄的方案更对路;如果只需要复制整张图的风格或单一主体,则不必用到这种词级调制拆解。页面标注该方法为 SIGGRAPH 2025 最佳论文,代码入口显示“coming soon”,实际使用前需确认代码是否已放出。
使用TokenVerse进行个性化生成需要准备什么格式的输入?
TokenVerse 的输入不是固定格式文件,而是“一张(或多张)图片 + 一段带概念词的文本描述”的组合。使用时需要准备:
- 概念图片:每个想定制的概念提供一张图,例如一件衬衫、一副眼镜、一个玩偶。资料说明它支持从单张图片中拆解出多个视觉元素,也支持多张图、每张图含多个概念。
- 文本描述:给图片中想提取的概念配上对应词,例如把图中的衬衫标为“shirt”、眼镜标为“glasses”。官网“Try Me”演示就是在提示词里点选高亮词来选定概念。
- 目标提示词:用这些概念词写一句想生成的画面,例如“A doll wearing a shirt, glasses and necklace in the beach.”,系统再把学到的概念按这个配置组合。
可处理的概念范围包括物体、配饰、材质、姿态和光照。实际操作上,概念图与文字标签要一一对应,描述越贴近图中内容,越利于它在调制空间中定位到该概念。
例如需要把自家产品放进新场景,就准备一张产品图、给它一个明确的名词标签,再写一句包含该名词的场景提示词。
TokenVerse支持哪些类型的概念个性化(如物体、材质、姿态、光照)?
TokenVerse 支持的概念个性化类型较广,官方明确列出的是:物体、配饰、材质、姿态和光照,并强调它不像已有方法那样受概念类型或覆盖广度限制。
具体支持范围
| 概念类型 | 用途 |
|---|---|
| 物体 | 从参考图中提取某个对象,再放进新场景 |
| 配饰 | 例如眼镜、项链等可分离的穿戴细节 |
| 材质 | 把某种材质特征迁移到新生成内容中 |
| 姿态 | 学习并复用参考图中的人物或物体姿态 |
| 光照 | 提取光照条件,用于新图合成 |
适用场景
例如需要把一张图里的“眼镜”和另一张图里的“项链”组合到同一个人物上,同时指定海滩场景和某种光照,这类多图、多概念组合就是它的目标用途。官网 “Try Me” 演示中,提示词里可点击选择的概念包括 Doll、Shirt、Glasses、Necklace,说明配饰与物体可以分别作为独立概念被调用。
选择条件
它更适合“一张图里含多个可分离概念、需要跨多张图自由组合”的个性化任务;如果只是单一物体替换,普通图像编辑或单概念定制方法可能更轻量。该工作发表于 SIGGRAPH 2025 并获 Best Paper Award,代码页标注为“coming soon”,实际使用前需确认代码是否已开放。
TokenVerse与现有个性化方法相比在概念广度和多图组合上有什么优势?
TokenVerse 的核心优势在于两点:概念类型覆盖更广,以及能从多张图片中各取多个概念再自由组合。它把每个概念在扩散模型的调制空间中编码成一个独立方向,因此不同概念可以拆开、重组,而不像许多现有个性化方法那样绑定在单一对象或单一图片上。
概念广度:不只管“物体”
按项目页说明,TokenVerse 支持的概念包括物体、配饰、材质、姿态和光照。多数个性化方法主要针对某个具体对象(例如把某件物品或某个人放进新场景),对材质、姿态、光照这类抽象或风格化属性支持有限。TokenVerse 把这些也当作可提取、可复用的概念,因此适合需要同时控制“东西是什么”和“东西怎么呈现”的生成任务。
多图多概念组合:一张图可出多个概念
TokenVerse 允许每张输入图片携带多个概念,也允许多张图片各自贡献概念,再拼成新组合。页面上的交互示例就是典型场景:分别从不同图片中选玩偶、衬衫、眼镜、项链,然后生成“玩偶戴眼镜和项链在海滩”的画面。相比只支持单图单概念的方案,这减少了反复换参考图、分步生成再合成的麻烦。
选择条件
- 需要从多张参考图各取一个或多个元素做混搭时,TokenVerse 的定位更贴合。
- 需要控制材质、光照或姿态,而不只是复制某个物体时,它的概念范围更有用。
- 如果任务只是把单一对象放进新场景,且对推理速度或即插即用部署要求高,可优先比较其他单概念个性化方法;TokenVerse 页面标注代码“coming soon”,实际可用性需以发布情况为准。
下一步
可先看项目页的 Results 与 Try Me 示例,判断它处理的概念类型是否覆盖你的素材;再对照 arXiv 上的论文了解调制空间的具体做法与实验设置。
如何引用或获取TokenVerse的官方代码与论文?
TokenVerse 的论文可直接引用官方 BibTeX,代码目前尚未发布,官方页面只标注“Code (coming soon)”。
论文引用
官方页面给出的 BibTeX 条目对应 SIGGRAPH 2025 论文(Best Paper Award),作者为 Daniel Garibi、Shahar Yadin、Roni Paiss、Omer Tov、Shiran Zada、Ariel Ephrat、Tomer Michaeli、Inbar Mosseri、Tali Dekel。引用时可直接使用页面 BibTeX 区块的条目,注意保留会议信息与共同一作标注。
获取代码
- 官方代码入口在 TokenVerse 页面,当前显示“Code (coming soon)”,尚无公开仓库链接。
- 页面同时列出 arXiv 入口,论文全文可从 arXiv 获取;代码发布后通常会同步更新在该页面。
- 现阶段如需复现,只能依据论文方法部分自行实现:基于 DiT 文本到图像模型,在 modulation 空间为每个词寻找独立方向,再组合生成。
使用建议
需要引用时优先用官方 BibTeX 保证格式准确;需要代码时定期查看项目页的 Code 链接是否从“coming soon”变为可用仓库,不建议从非官方渠道获取所谓实现。
 Amazon Route 53
 Fastly
用户评价(0)