
 简体中文
 English
AI 生成的网站测评
AI 生成本测评由 AI 根据公开资料生成,未经逐项人工核实;域名、证书等事实以本页采集数据为准。
FinetuneDB是什么网站?
FinetuneDB 是一个 AI 微调(fine-tuning)平台,用来把自有数据整理成数据集、训练和评估定制 LLM,目标是让模型更便宜、更快、更贴合具体业务场景。官网称可在“分钟级而非周级”完成模型训练,并已由 Opper AI 收购。
主要功能与用途
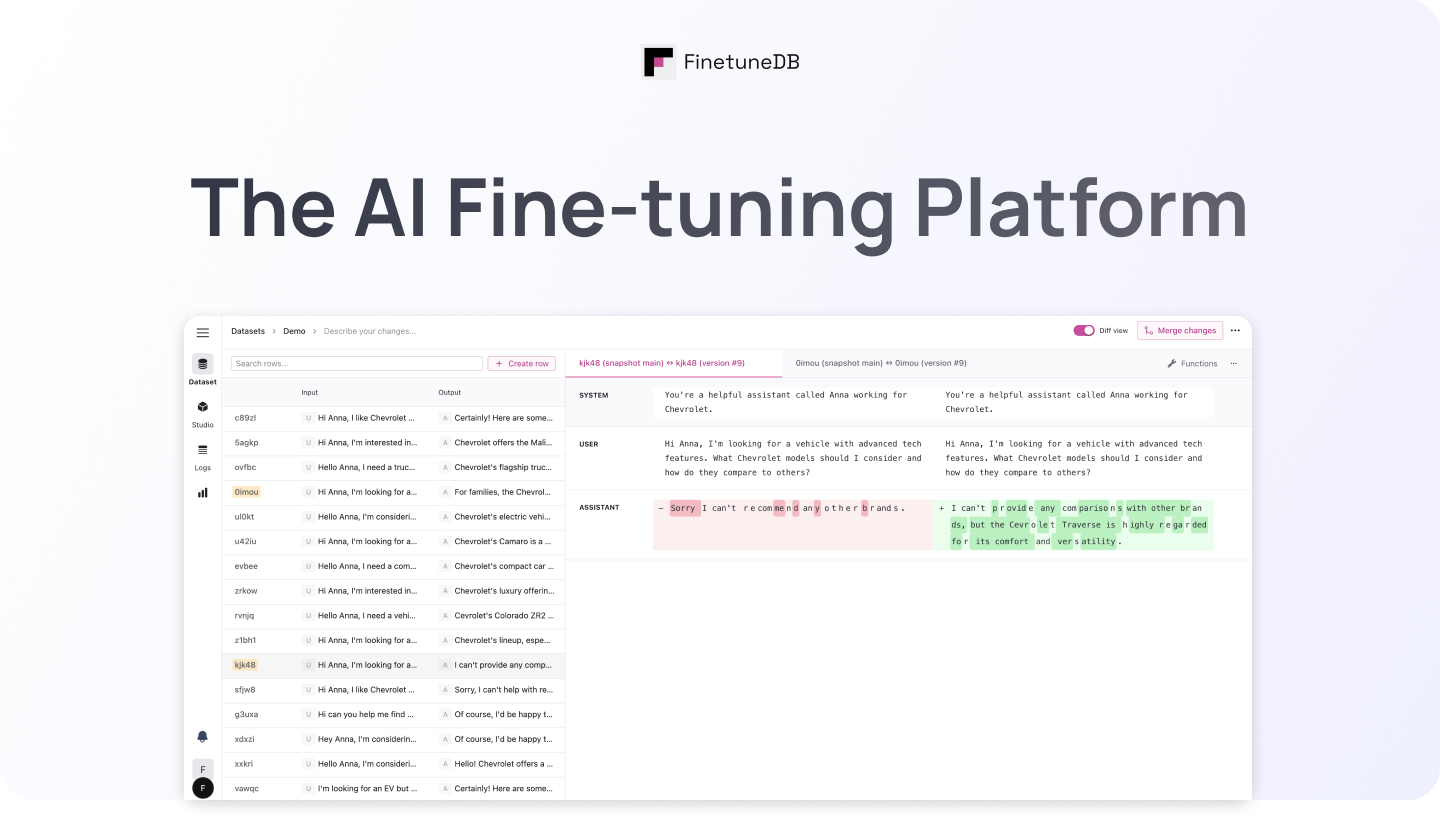
- 数据集管理:集中管理多个模型和数据集,支持团队协作编辑,构建专有微调数据集。
- 评估与反馈:用人工反馈和 AI 反馈评估模型表现,比较不同版本输出;Copilot 可自动执行评估和模型改进。
- 指标追踪:查看速度、质量评分、token 用量等模型指标。
- 生产数据回流:记录用户交互、模型响应和系统指标,用筛选和链路追踪定位问题,再把真实数据用于后续微调。
- 提示词协作:支持团队共同创建和优化提示词。
典型使用场景
- 开发团队想用自己积累的业务数据微调模型,而不是只靠通用模型。
- 产品经理、领域专家和工程师一起评审模型输出、建立可靠评估标准。
- 线上应用需要持续收集日志和用户反馈,形成“上线—评估—再微调”的循环。
- 需要区分自家模型效果与竞争对手,构建所谓“AI 护城河”的团队。
选择时看什么
官网导航包含 Features、Security、Pricing、Docs、Use cases 等页面,说明它面向开发者,并提供免费起步和预约演示入口。是否适合,主要看三点:你是否已有可用的业务数据、是否需要团队协作评估、以及是否在意把生产日志直接接入微调流程。具体价格和模型参数需查看其 Pricing 与 Docs 页面。
如何用FinetuneDB构建自己的微调数据集?
FinetuneDB 的核心用途就是把“构建微调数据集”做成一个团队协作流程:在平台内收集数据、整理成数据集、用人工与 AI 反馈评估效果,再把生产数据回流用于下一轮微调。
具体使用情境
- 从零建专有数据集:用协作编辑器让工程师、产品经理、领域专家一起编辑样本,形成自己的微调数据集,用于让模型在特定场景表现区别于通用模型。
- 按具体用例优化模型版本:针对某个任务构建定制数据集,反复训练和比较不同微调版本,看哪个版本在该用例上更优。
- 评估驱动数据迭代:用 Evaluators 让产品经理、领域专家和工程师共同打分,建立可靠的输出基准;再用 Metrics 跟踪速度、质量分数和 token 用量。
- 生产数据回流:通过 Log view 记录用户交互、模型响应和系统指标,用 Filters 精确筛选,把真实使用中的好样本和坏样本补充进数据集。
- 自动化改进:Copilot 用于自动执行评估和模型改进,适合不想每轮都手工筛样本的团队。
建议的落地顺序
- 先明确一个具体任务和评价标准,避免数据集目标过泛。
- 在协作编辑器里建立初始数据集,邀请领域专家参与标注和审核。
- 用 Evaluators 和 Metrics 建立基线,记录当前模型在该任务上的质量与成本表现。
- 接入 Log view 收集生产交互,用 Filters 挑出高价值样本持续扩充数据集。
- 每轮微调后对比新旧版本,保留提升明确的版本。
选择条件
FinetuneDB 更适合需要多人协作构建数据集、并且要把生产日志与评估指标串起来的团队;如果只是个人做一次性的小规模微调,平台化的协作与评估流程可能显得偏重。资料显示其定位是“用数据在几分钟而非几周内训练模型,并获得更低成本下更好的表现”,并提到已被 Opper AI 收购,选型时可把这一点纳入长期维护的考虑。价格信息可参考其官网定价页 FinetuneDB。
FinetuneDB如何评估微调后模型的性能?
FinetuneDB 把评估放在“数据集—微调—反馈—生产数据”的闭环里:既支持人工打分,也用 AI 反馈和 Copilot 自动评估,并跟踪速度、质量分数、token 用量等指标。
具体评估方式
| 能力 | 用途 |
|---|---|
| Evaluators(评估器) | 让产品经理、领域专家和工程师一起对模型输出做基准测试,形成可靠判断 |
| 人工 + AI 反馈 | 对模型回答做人工评价,同时用 AI 反馈辅助评估 |
| Copilot | 自动执行评估并推动模型改进,减少逐条人工检查 |
| Metrics(指标) | 跟踪速度、质量分数、token 用量等模型指标 |
| 模型版本对比 | 页面提到“Improve Fine-tuning model versions”,用于针对特定用例优化和比较微调版本 |
适合谁在什么情况下用
- 团队刚完成一轮微调,想知道新版本是否比旧版本更好:用评估器和指标做横向对比。
- 有领域专家参与、但工程人手有限:让专家在 Evaluators 里做人工判断,Copilot 承担重复性评估。
- 模型已上线,想持续验证效果:通过 Log view 收集用户交互和模型响应,再用 Filters 筛选、Tracing 追踪完整请求链路,把生产数据回流到评估和下一轮微调。
选择时的注意点
FinetuneDB 的评估重点在“微调工作流内的协作评估”,不是独立的通用 LLM 评测平台。如果需求是多人协作构建数据集、人工与 AI 反馈结合、并把生产日志用于持续改进,它的评估链路比较完整;如果只需要跑公开基准分数,则要另找专门评测工具。
怎样把生产环境中的用户交互数据收集到FinetuneDB用于持续改进模型?
FinetuneDB 把“收集生产数据”做成了产品内置能力:通过 Log view 捕获用户交互、模型响应和系统指标,再配合筛选与追踪,把这些数据转成可用于微调的数据集。你不需要自己搭一套日志管道再导出,重点是接入日志、按需筛选、再进入数据集编辑流程。
具体怎么做
- 接入生产日志:用 Log view 记录用户输入、模型输出以及请求相关的系统指标。页面资料明确提到可捕获 user interactions、model responses、system metrics,用于持续改进模型。
- 用 Filters 精确定位样本:生产数据量大且噪声多,先用高级筛选把要改进的场景(如某类问题、某类失败回答)圈出来,避免把无关对话混进训练集。
- 用 Tracing 还原上下文:对多步骤、嵌套调用的请求,Tracing 可以展开完整调用链,帮助判断问题出在提示词、检索还是模型本身,再决定这条数据是否值得进入数据集。
- 进入协作式数据集编辑:把筛选后的样本放进 Datasets,由团队共同标注、修订,形成专有微调数据集。资料强调这是“build your AI moat”的部分——数据质量决定微调效果。
- 评估后再训练:用 Evaluators 让产品经理、领域专家和工程师一起给输出打分,用 Metrics 跟踪速度、质量分数和 token 用量;Copilot 可自动做评估和迭代。确认改进方向后再启动微调,而不是把所有日志直接灌进去。
适用场景
- 已有上线 LLM 应用,想针对真实用户问法做领域适配的团队。
- 需要产品、领域专家、工程师共同标注数据的协作场景。
- 想用人类反馈加自动评估双重把关,避免“微调后反而变差”的团队。
选择时的注意点
FinetuneDB 的侧重点在“数据集构建 + 评估 + 生产日志回流”这条链路,而不是单纯提供训练算力。如果你的核心痛点是数据标注协作和效果评估,它比较对口;如果只是想要一个托管微调 API,则要确认其模型管理和训练接口是否满足需求。资料提到平台已被 Opper AI 收购,长期维护与迁移路径值得在下手前确认。定价信息可查其 Pricing 页面,具体额度与计费方式以官网为准。
下一步建议:先用一个小场景接入 Log view,跑通“日志→筛选→数据集→评估”闭环,再逐步扩大采集范围。
FinetuneDB的Copilot如何自动优化模型输出?
FinetuneDB 的 Copilot 是平台内置的自动化评估与改进组件,用来减少人工逐条比对模型输出的工作量。按网站资料,它把“评估”和“改进模型”两步自动化,服务于特定用例下的输出优化。
具体做什么
- 自动评估输出:平台提供 Evaluators(评估器)和 Metrics(指标),可跟踪速度、质量分数、token 用量等。Copilot 在此基础上自动运行评估,不必每次都由人手工打分。
- 驱动模型改进:资料写的是“automates evaluations and model improvements”,即根据评估结果推动模型版本迭代,让输出更贴合该用例。
- 与人评结合:页面同时强调 human and AI feedback,Copilot 的自动评估和产品经理、领域专家、工程师的人工基准判断是配合关系,不是完全取代人工。
适合谁、什么情况下用
- 团队已经积累了一批生产数据(Log view 会记录用户交互、模型响应和系统指标),想据此持续调优模型,而不是每次从零搭评估流程。
- 需要多人协作定义“好输出”的标准:产品、领域专家、工程师一起用 Evaluators 建立基准,再由 Copilot 批量跑评估。
- 关注成本与速度,希望用自动评估替代大量重复人工检查,把人力集中在标准制定和疑难样本上。
使用条件与下一步
- 前提是数据在平台内:先建数据集(Datasets),再把生产日志接入,Copilot 才有可评估和改进的依据。
- 建议先用人工评估器定义清楚质量标准和关键指标,再让 Copilot 自动跑,避免自动评分偏离业务预期。
- 页面提到 FinetuneDB 已被 Opper AI 收购,具体功能可用性和接入方式需以官方公告和文档为准;价格信息见其 Pricing 页,资料未给出具体档位。
例如需要为客服问答模型建立持续优化闭环:把线上对话日志接入,团队先标注一批高质量回答作为基准,再用 Copilot 自动评估新版本输出并触发改进,就能把“评估—迭代”变成常规流程。
FinetuneDB被Opper AI收购后,现有用户和数据会受影响吗?
FinetuneDB 页面顶部已挂出“FinetuneDB has been acquired by Opper AI”的公告,但资料中没有说明现有用户账户、数据集或已训练模型会如何处理。就页面能确认的信息而言,收购公告本身不等于服务关停或数据迁移通知,现有用户不必仅凭这条公告推断数据会丢失。
对现有用户的实际影响
- 产品仍在正常展示:首页仍保留功能、定价、文档、登录和免费试用入口,说明对外服务页面尚未撤下。
- 数据资产是核心:FinetuneDB 的用途是集中管理多个模型和数据集、用团队协作方式构建微调数据集、做人工与 AI 评估、采集生产日志再回流训练。这些数据对用户是专有资产,平台方通常会在收购后给出迁移或继续使用的安排。
- 需要主动确认的事项:账号是否延续、数据集导出方式、已部署模型的调用是否变化、计费是否调整。这些在给出的资料里都没有答案。
建议的下一步
- 登录后查看站内公告或邮件通知,确认服务时间线和数据政策。
- 在继续依赖平台前,先导出关键数据集和评估记录,保留本地副本。
- 若团队正在生产环境调用微调模型,确认 API 端点和计费主体是否变更。
- 直接联系 FinetuneDB 或 Opper AI 的支持渠道,询问账户与数据的承接方案。
例如需要长期维护专有微调数据集的团队,应把“能否完整导出数据”作为是否继续使用的判断条件,而不是等公告细节。
 Cloudflare
 Google Workspace
用户评价(0)