
 简体中文
 English

projector.tensorflow.org
Visualize high dimensional data.
快速了解
- 分类
- 数据查询与分析
- 语言
- 未知
- 付费内容信号
- 暂未发现付费内容已观察
- 注册年份
- 2015
- 主机
- Fastly推测
- HTTPS 证书信任
- 通过已观察
- 最后更新
相关问题
更多相关问题 →用 CCVisu 做图聚类与力导向布局:从输入文件到结果解读
CCVisu 是一个命令行工具,用来对图数据做力导向布局,并可选地在布局过程中进行图聚类。它适合把软件结构、依赖关系或任意边列表转成一张能看出"哪些节点抱团、哪些节点游离"的二维图。前提是你有一个可用的 Java 运行环境,并且能接受用命令行而不是图形界面来操作。下面按"准备输入 → 选模式 → 运行 → 解读 → 排错"的顺序说明。
准备 CCVisu 能读的输入
CCVisu 的核心输入是一张图,最直接的写法是边列表:每行一条边,两个节点标识符用空白分隔。节点标识符可以是名字、路径或编号。
A B
A C
B C
D E
如果图里存在孤立节点(没有任何边),边列表无法表达它们,需要改用能声明节点的格式。CCVisu 支持 RSF(Relation Specification Format)这类带关系声明的写法,常见形式是每行给出关系名和两个端点:
depends A B
depends A C
depends B C
depends D E
准备输入时确认三件事:
- 分隔符一致:同一文件里不要混用空格和制表符以外的分隔方式。
- 节点名不重复歧义:同名节点会被当作同一个点,想区分要加前缀。
- 文件编码统一:含非 ASCII 名称时用 UTF-8,避免解析阶段就报错。
选择布局模式:普通力导向还是聚类布局
CCVisu 的两种用法对应不同的输出意图,选错模式会得到"看起来乱"或"过度抱团"的结果。
| 维度 | 普通力导向布局 | 聚类布局 |
|---|---|---|
| 目标 | 按边的连接强度把节点拉开/聚拢 | 在布局的同时显式划分簇 |
| 适合场景 | 想看整体结构、找桥接节点 | 想直接得到分组结论 |
| 输出侧重 | 位置反映连接关系 | 位置 + 簇归属 |
| 主要调节 | 迭代次数、斥力/引力相关参数 | 聚类相关参数 + 迭代次数 |
判断方法:如果你只想知道"这张图长什么样",先用普通力导向;如果你已经预期图里存在若干社区,想让工具帮你把边界画出来,用聚类布局。
运行命令行并设置关键参数
CCVisu 以命令行方式调用,典型结构是"指定输入文件 + 指定输出文件 + 选择布局/聚类选项"。由于不同版本的参数名可能不同,运行前先用帮助选项确认当前版本支持的写法:
java -jar ccvisu.jar --help
一次典型运行包含这些要素:
- 输入:你的边列表或 RSF 文件路径。
- 输出:布局结果文件,通常是坐标加节点名的文本,可再转成图形。
- 迭代次数:控制力导向计算的轮数。轮数太少布局不收敛,节点位置还在乱动;轮数太多则耗时增加但形状变化很小。
- 布局/聚类开关:决定走普通力导向还是聚类路径。
预期结果:命令结束后生成一个输出文件,里面每个节点带一组二维坐标(聚类模式下还会带簇编号)。如果输出文件为空或只有表头,说明输入没被正确解析,先回到上一步检查格式。
解读生成的布局图
把输出坐标画成散点图后,按下面的线索读:
- 紧密成团的节点:彼此边多、距离近,通常对应一个模块或一组高耦合的类/文件。
- 团与团之间的细长连接:少数跨组的边,往往是模块间的接口或依赖,是重构时最值得关注的位置。
- 离群节点:远离所有团、连接很少的点,可能是孤立功能、死代码或数据噪声。
- 中心节点:位于多个团之间、连接度高的点,常是核心类或公共依赖,改动它影响面大。
聚类模式下,簇编号直接给出分组,但要注意:簇的划分是算法基于当前图结构算出来的,不等于业务上正确的模块划分。它是一份"结构证据",需要你结合代码或领域知识判断是否合理。
常见失败与排查
输入解析错误 现象:报错或输出为空。原因通常是分隔符不一致、节点名含特殊字符、或用了工具不认识的格式。排查:先用一个只有两三条边的最小文件测试,确认格式被接受后再换真实数据。
布局不收敛 现象:多次运行结果差异大,或节点位置明显不合理。原因多与迭代次数不足或图规模过大有关。排查:逐步提高迭代次数,观察结果是否趋于稳定;图很大时先抽取子图验证参数。
输出为空或缺少节点 现象:输出文件没有内容,或节点数少于预期。原因可能是孤立节点未被边列表表达,或某几行被当成注释/非法行跳过。排查:核对输入行数与预期边数,把孤立节点显式声明出来。
结果图"糊成一团" 现象:所有节点挤在一起看不出结构。原因可能是图本身连接过密,或斥力相关参数偏小。排查:先确认图是否真的高度连通;若是,考虑先按权重过滤掉弱边再布局。
什么时候该用 CCVisu
如果你的目标是从一份边关系数据出发,快速得到一张能看出分组和关键节点的布局图,并且愿意用命令行和文本输出,CCVisu 是合适的选择。它不提供交互式图形界面,也不负责帮你从源码自动抽取依赖——那部分需要你先用别的工具生成边列表或 RSF,再交给它做布局与聚类。把输入格式和模式选对,后面的解读和排错就有据可依。
机器学习是什么?它能解决哪些问题、如何开始使用
机器学习是让计算机从数据中自动找出规律、并据此对新数据做出预测或判断的方法。它适合规则难以写清、但你有大量历史数据可用的任务,比如判断邮件是否为垃圾邮件、预测房价、把客户分成几类。如果你的问题能用几条明确的 if-else 规则写死,或者根本没有数据可学,那通常不需要机器学习。想动手的话,BigML 这类平台提供可视化界面和 API,官网写明注册后可获得 3 天免费试用,能访问其全部功能。
机器学习和普通编程、统计分析有什么不同
普通编程是"人写规则,机器执行":你告诉程序"如果金额大于 5000 且异地登录,就标记为可疑"。机器学习是"人给数据和目标,机器找规则":你给一批已标注为正常/可疑的交易,让算法自己总结出判断依据。
和统计分析相比,统计更关注解释数据中的关系和显著性,机器学习更关注对新样本的预测效果——模型在没见过的数据上准不准,往往比它在训练数据上拟合得多好更重要。
适合用机器学习的典型信号:
- 规则太多、太模糊,人工写不完或写不准(如识别图片里有没有猫)。
- 规律会随时间变化,需要模型能重新训练更新(如欺诈手法不断演变)。
- 有可用的历史数据,且这些数据里包含你想要的答案(标签)。
常见任务类型和对应场景
| 任务类型 | 要解决的问题 | 实际场景举例 |
|---|---|---|
| 分类 | 判断样本属于哪个类别 | 垃圾邮件识别、客户流失预测 |
| 回归 | 预测一个连续数值 | 房价预估、销量预测 |
| 聚类 | 把相似样本自动分组,无预设标签 | 客户分群、文档归类 |
| 异常检测 | 找出与大多数样本明显不同的点 | 设备故障预警、异常交易 |
分类和回归属于"有监督学习",训练数据里要有正确答案(标签);聚类和异常检测常属于"无监督学习",不需要预先标注。选哪种,取决于你的数据有没有标签、以及你想得到类别还是数值。
从数据到预测的典型流程
- 明确问题:先确定要预测什么、预测结果怎么用。比如"预测下月哪些客户会流失",而不是笼统的"分析客户"。
- 准备数据:收集、清洗、整理成一张表,每行一个样本,每列一个特征,外加一列目标值。缺失值、异常值、量纲不一致都会影响效果。
- 训练模型:把数据分成训练集和测试集,用训练集让算法学习规律。
- 评估模型:用测试集看预测效果。分类常用准确率、精确率、召回率,回归常用误差指标。关键是看它在没见过的数据上的表现。
- 部署预测:把模型接入实际业务,对新数据输出预测结果,并持续监控效果、必要时重新训练。
每一步都有坑:数据质量差,再好的算法也救不回来;模型在训练集上表现完美、在测试集上很差,就是过拟合;只看一个总体指标,可能掩盖了某类样本预测很差的问题。
怎么开始上手
对新手来说,可视化平台比直接写代码更容易起步。以 BigML 为例,官网描述其定位是"让机器学习对每个人都变得简单",提供数据集、模型、WhizzML 等资源,并支持 API 调用,适合既想用界面拖拽、又想用程序批量操作的场景。注册方式包括邮箱注册,也支持用 Amazon、GitHub、GitLab、Google 账号登录。
入门路径可以这样安排:
- 先用小数据集跑通一遍:找一个自己熟悉的表格数据(如带标签的客户记录),走完训练和评估流程,理解每一步在做什么。
- 用可视化工具降低门槛:在界面上传数据、选算法、看结果,不必一开始就纠结代码。
- 需要自动化时再用 API:当你要把预测接入自己的系统、或批量处理数据时,API 和可编程工具(如 WhizzML)才有价值。
- 参考现成资源:平台上的公开数据集和模型示例,能帮你快速理解输入输出长什么样。
关于费用,官网只写明注册后可获得 3 天免费试用、可访问全部功能,并设有定价、预订计划、私用部署、培训、认证等页面。具体价格和长期使用条件需以官网定价页为准,这里不做推断。
容易踩的几个误区
- 以为数据越多越好:数据质量、标注准确性往往比数量更关键,脏数据会直接带偏模型。
- 忽视过拟合:模型把训练数据的噪声也背下来了,换新数据就不准。用独立的测试集验证是基本防线。
- 只看准确率:在类别极不均衡时(如 99% 都是正常样本),一个"全猜正常"的模型准确率也有 99%,但毫无用处。
- 忽略可解释性和隐私:在医疗、金融等场景,模型为什么这么判断、数据是否合规,和预测准不准同样重要。BigML 官网也把"可解释和可导出的模型""安全和隐私"列为平台特点。
- 指望一次训练永久有效:数据分布会变,模型需要定期评估和更新。
一句话总结:机器学习是用数据找规律来做预测的工具,适合规则难写、有历史数据的场景;入门可以从可视化平台的小数据集练手开始,重点盯住数据质量、过拟合和评估方式这三件事。
什么是JavaScript闭包?
JavaScript闭包是指函数能够“记住”并访问其定义时所处作用域的能力,即使该函数在其定义作用域之外被执行。简单说,闭包由“函数”加上“该函数创建时所在的作用域”共同构成,让内部函数可以读取外部函数的局部变量,而这些变量在外部函数返回后依然存在。
理解闭包需要先区分作用域与生命周期。普通局部变量在函数执行结束后会被回收,但闭包打破了这一默认行为。例如:
function outer(x) {
return function inner(y) {
return x + y;
};
}
const addFive = outer(5);
console.log(addFive(3)); // 输出 8
这里inner函数引用了outer的参数x。outer执行完毕后,按常规x应被销毁,但由于inner仍持有对x的引用,JavaScript引擎会保留x所在的作用域,使addFive在后续调用时仍能访问x=5。inner与这个被保留的作用域合起来就是闭包。
闭包最常见的用途是创建“私有变量”,即无法从外部直接访问、只能通过特定函数操作的数据。例如计数器:
function createCounter() {
let count = 0;
return {
increment: function() { count++; },
get: function() { return count; }
};
}
const counter = createCounter();
counter.increment();
counter.increment();
console.log(counter.get()); // 输出 2
这里的count对外不可见,只能通过increment和get修改或读取,实现了类似其他语言中私有字段的效果。这在模块化代码、事件处理器和回调函数中非常普遍。
闭包也容易引发问题,最常见的是循环中误用var声明变量。例如给多个按钮绑定点击事件时,若在for循环中用var定义循环变量i,所有回调共享同一个i,最终都显示循环结束后的值。解决办法是用let声明(每次迭代创建独立绑定),或通过立即执行函数传入当前值。
闭包与普通函数、箭头函数的关键区别在于:箭头函数没有自己的this,它继承定义时外层作用域的this,因此不适合用作需要动态this的方法;而普通函数作为闭包时,this取决于调用方式。此外,闭包会持续占用内存,因为被引用的作用域无法释放,大量不必要的闭包可能导致内存占用上升,在长生命周期对象中应避免持有大对象。
判断一个函数是否形成闭包,看它是否引用了自身定义作用域之外的变量。若函数只使用自己的参数和局部变量,则不构成闭包。闭包是JavaScript函数式编程的基础,也是理解事件循环、模块模式和柯里化的前提。
Embeddings 是什么:机器学习中的嵌入向量与高维数据可视化
Embeddings(嵌入向量)是把对象(词、句子、图片、用户等)映射成一组稠密数值的表示方式,使语义相近的对象在向量空间中距离更近。它适合处理“比较相似性、检索、聚类、分类”这类任务;如果你只是要观察已有向量之间的关系,可以用 Embedding Projector 这类工具把高维向量降维后可视化,但降维图只能作为参考,不能替代原始任务上的评估。
为什么需要 embeddings
传统做法常用 one-hot 或稀疏计数表示对象:每个词一个维度,维度数等于词表大小,任意两个词的距离几乎一样,无法表达“相似”。Embeddings 把对象压缩到几十到几百维的稠密向量,训练目标通常让“经常出现在相似上下文中的对象”向量接近。结果是:
- 向量可以做算术和距离计算,便于机器比较。
- 维度远低于词表规模,存储和计算更可行。
- 相似性可以迁移到检索、推荐、聚类等下游任务。
一个直观例子
假设有三个词:“猫”“狗”“汽车”。在好的词嵌入中,猫 与 狗 的向量夹角小、距离近,而它们与 汽车 的距离明显更远。把这三个向量画在二维平面上,前两个点会聚在一起,第三个点落在别处。这就是“语义相似 → 向量接近”的最小例子。
如何比较两个向量
常见方法有两类:
| 方法 | 计算方式 | 适用场景 |
|---|---|---|
| 余弦相似度 | 两向量夹角的余弦值,只看方向不看长度 | 文本嵌入最常用,长度差异不重要时 |
| 欧氏距离 | 两向量差的平方和开方 | 向量已归一化或长度本身有含义时 |
实践中常先把向量归一化,再用点积或余弦相似度排序。需要注意:不同模型产出的向量空间不可直接混用,换模型后相似度阈值要重新校准。
常见类型与用途
- 词嵌入:把词映射为向量,用于文本分类、相似词查找、作为下游模型输入。
- 句子/文档嵌入:把整段文本压成一个向量,用于语义检索、去重、聚类。
- 图像嵌入:用卷积网络或视觉模型提取图片向量,用于以图搜图、图像聚类。
- 用户/物品嵌入:推荐系统中把用户和物品放进同一空间,用向量接近程度表示偏好匹配。
类型不同,但共同点是:向量本身不直接可读,价值在于“距离和方向可比较”。
用 Embedding Projector 观察高维向量
Embedding Projector(projector.tensorflow.org)是一个在浏览器中可视化高维数据的工具,页面描述为“Visualize high dimensional data”。典型使用流程如下:
- 准备向量文件:一个文件存放向量(每行一个对象,每列一个维度),另一个文件存放对应的标签或元数据(每行一个名称)。两者行数必须一致。
- 加载数据:在工具中上传或指定这两个文件,确认对象数量与维度数匹配。
- 选择降维方法:常见有 PCA、t-SNE、UMAP 等。PCA 偏重保留全局方差,t-SNE/UMAP 更强调局部邻域结构。
- 观察与交互:按标签着色、搜索某个对象、查看其近邻,判断同类对象是否聚在一起。
- 验证:把可视化中发现的“疑似相似”对象回到原始任务中检查,例如用余弦相似度排序或人工抽查。
常见卡点
- 行数不一致:向量文件与标签文件行数不同,加载会失败或错位。
- 维度声明错误:文件头或参数中的维度与实际列数不符。
- 把降维图当结论:t-SNE 的簇间距离和簇大小不宜直接解读;换随机种子或参数,布局可能明显变化。
- 未归一化就比较:长度差异大的向量直接算欧氏距离,可能被长度主导。
可视化结果该怎么读
降维可视化适合回答“有没有明显分群”“同类是否大致靠拢”“有没有离群点”,不适合回答“两个簇相距多远”“簇的面积代表什么”。原因在于 t-SNE、UMAP 等非线性降维会扭曲全局距离。稳妥做法是:
- 用可视化提出假设(例如“这两类可能混淆”)。
- 回到原始高维向量,用余弦相似度或下游任务指标验证。
- 记录降维方法、参数和随机种子,便于复现。
选择建议
如果你要理解概念或做初步探索,先在一小批已知标签的数据上跑可视化,确认同类是否聚拢,再扩大到真实数据。如果你要做检索或分类,重点应放在嵌入模型的选择和相似度阈值校准上,可视化只作为排查手段。若向量维度很高、样本量大,优先抽样后再可视化,避免交互卡顿和图形过密导致误读。
如何在网页中引入JavaScript?
在网页中引入JavaScript主要有三种方式:内联脚本、内部脚本和外部脚本。
-
内联脚本(Inline Script)
直接写在HTML标签的事件属性中,例如<button onclick="alert('你好')">点击</button>。这种方式适合极简单的交互,但代码混杂在HTML里,难以维护,不推荐在正式项目中使用。 -
内部脚本(Internal Script)
将JavaScript代码放在<script>标签内,并置于HTML文档的<head>或<body>中。例如:
<!DOCTYPE html>
<html>
<head>
    <meta charset="UTF-8">
    <title>示例</title>
    <script>
        function greet() {
            alert('页面加载完成');
        }
    </script>
</head>
<body>
    ...
</body>
</html>
内部脚本适合单个页面使用、代码量不大的场景。需要注意:如果脚本放在<head>中且需要操作页面元素,应使用window.onload或DOMContentLoaded事件,确保元素已加载完成,否则可能找不到元素。
- 外部脚本(External Script)
将JavaScript代码保存为独立的.js文件,再通过<script src="文件路径"></script>引入。这是最推荐的方式,因为它将结构(HTML)、样式(CSS)和行为(JS)分离,便于复用和缓存。例如:
<script src="js/main.js"></script>
外部脚本的src属性可以使用相对路径(如./js/main.js)、绝对路径或完整的URL(如CDN链接)。浏览器会按顺序加载多个外部脚本,默认情况下是同步阻塞的——即遇到<script>标签时,页面会暂停渲染,先下载并执行脚本,再继续解析后续HTML。
放置位置的建议
传统上,脚本放在<head>中会导致页面白屏时间变长,因为脚本下载和执行会阻塞渲染。因此,对于不需要在页面解析前执行的脚本,通常放在<body>标签的末尾(</body>之前)。这样页面内容先显示,脚本最后加载,用户体验更好。
现代增强属性
如果外部脚本不需要等待DOM解析,可以在<script>标签上使用defer或async属性:
- defer:脚本会延迟到文档解析完成后再执行,多个defer脚本按出现顺序执行。
- async:脚本下载与HTML解析并行进行,下载完成后立即执行,不保证多个async脚本的执行顺序。
常见错误提醒
- 忘记写</script>结束标签会导致脚本解析错误。
- 外部脚本文件路径写错(如大小写、目录层级)时,浏览器控制台会报404错误,页面功能失效。
- 在<head>中直接操作<body>里的元素会得到null,因为元素尚未解析。
如何确认引入成功
打开浏览器开发者工具(F12),切换到“控制台”(Console)面板。如果脚本中有console.log输出,能看到对应信息;若脚本语法错误,控制台会显示红色报错及行号。也可以直接在控制台输入脚本中定义的函数名,若能调用则说明脚本已正确加载。
网站信息概览
从公开技术信号来看,历史连续性与托管能力相互印证,网站更像经过长期维护的正式项目,而不是短期上线后即弃用的页面。结合现有公开信息推测,页面发现配置存在多处空白,这不一定影响基础访问,却可能让索引归一、结果页表达和分享转化同时受损。
域名与注册信息
域名最早登记于 2015 年,注册历史相对较长。从当前可见信息判断,登记信息显示使用 MarkMonitor Inc. 的企业域名管理服务。域名处于正常锁定状态,可降低未经授权转移的风险。顶级域为 .org,本身不提供额外的身份信号。
DNS 与邮件配置
存在 MX 记录,但未检测到 SPF、DKIM 或 DMARC。结合现有公开信息推测,DNS 托管可识别为 Google Cloud DNS。依据当前可见线索,MX 记录使用 Google Workspace 企业邮箱服务。依据当前可见线索,CNAME 目标 tensorflow.github.io 与 GitHub Pages 平台相匹配。从当前可见信息判断,第三方验证记录涉及 Google。
TLS 与证书
RSA 密钥长度为 2048 位,符合当前常见配置。TLS 握手提供了完整的证书链数据。证书可验证域名控制权,但现有数据不能确认组织身份。从公开技术信号来看,证书由 Let's Encrypt 签发,采用常见的自动化短周期证书服务。证书总有效期约 89 天,符合短周期自动续期模式。
HTTP 响应
HTTP 响应没有提供常用的附加安全策略。该资源采用开放的跨域读取策略。HTTP 头没有直接暴露后端框架。依据当前可见线索,响应中的 x-cache、x-served-by、via 表明流量经过 CDN 或缓存代理。HTTP 字段未显示敏感内部网络标识。
技术栈分析
现有迹象表明,站点可见的技术栈为 Google Analytics、Fastly,精确版本未知。技术名称本身提供了架构线索,但目前没有证据表明某个具体版本存在问题。
SEO 与社交分享
首页描述:未知。页面未检测到 Viewport 元标签。首页未检测到 Canonical 规范链接。Title 信息完整,共 60 个字符。页面允许搜索引擎收录和跟踪链接。
主机和电子邮件
 Google Cloud DNS
 Fastly
 Google Workspace
域名登记事实
| 注册商 | MarkMonitor Inc. |
|---|---|
| 注册时间 | 2015-08-25 |
| 到期时间 | 2027-08-25 |
| 域名状态 | client delete prohibited、client transfer prohibited、client update prohibited |
| 名称服务器 | ns-cloud-c1.googledomains.com、ns-cloud-c2.googledomains.com、ns-cloud-c3.googledomains.com、ns-cloud-c4.googledomains.com |
| DNSSEC | unsigned |
DNS 记录
| 类型 | 名称 | 值 | TTL | 优先级 |
|---|---|---|---|---|
| A | tensorflow.github.io | 185.199.108.153 | 3600 | — |
| A | tensorflow.github.io | 185.199.109.153 | 3600 | — |
| A | tensorflow.github.io | 185.199.110.153 | 3600 | — |
| A | tensorflow.github.io | 185.199.111.153 | 3600 | — |
| AAAA | tensorflow.github.io | 2606:50c0:8000::153 | 3600 | — |
| AAAA | tensorflow.github.io | 2606:50c0:8001::153 | 3600 | — |
| AAAA | tensorflow.github.io | 2606:50c0:8002::153 | 3600 | — |
| AAAA | tensorflow.github.io | 2606:50c0:8003::153 | 3600 | — |
| MX | tensorflow.org | aspmx.l.google.com | 300 | 1 |
| MX | tensorflow.org | alt1.aspmx.l.google.com | 300 | 5 |
| MX | tensorflow.org | alt2.aspmx.l.google.com | 300 | 5 |
| MX | tensorflow.org | alt3.aspmx.l.google.com | 300 | 10 |
| MX | tensorflow.org | alt4.aspmx.l.google.com | 300 | 10 |
| NS | tensorflow.org | ns-cloud-c1.googledomains.com | 21600 | — |
| NS | tensorflow.org | ns-cloud-c2.googledomains.com | 21600 | — |
| NS | tensorflow.org | ns-cloud-c3.googledomains.com | 21600 | — |
| NS | tensorflow.org | ns-cloud-c4.googledomains.com | 21600 | — |
| TXT | tensorflow.org | google-site-verification=8BeJx_QNi-UYmUtA-s_LwjRTHYaD3dUuScW6yWJ1ll0 | 300 | — |
| TXT | tensorflow.org | google-site-verification=FAtbPSvbHZAsXSctJdRh6NqtZ9hiqh_kpHCjCZGbtK8 | 300 | — |
| TXT | tensorflow.org | google-site-verification=FO-asi2Djdtu7CEiXqj2n80rSNcub6WhE1r9L9z6oy8 | 300 | — |
| TXT | tensorflow.org | google-site-verification=QNIZ02ik6DHanav0Ubf2AEE0Cwj3QosClem0_euvXkw | 300 | — |
| TXT | tensorflow.org | google-site-verification=Vkyt5mqyb-P34Ml0V8lKVja03ei0oPLCZ3ZCOBduc3Y | 300 | — |
| TXT | tensorflow.org | google-site-verification=X8e_3ME8hmVBfXrryoejTpijLplKKSbDDBqKUFxJULA | 300 | — |
| TXT | tensorflow.org | google-site-verification=XFmqvz7DWBJ7KR-e6wgiIYl8e7o8rSUqP5j1QIM1k7o | 300 | — |
| TXT | tensorflow.org | google-site-verification=ZUIlu5kbb0_nreS5Lt6lvD_1SRhbVsGq6TL21s9Gaas | 300 | — |
| TXT | tensorflow.org | google-site-verification=_8hwbyJ2D3u3458Fk9vBuhCCqRwPq15MdsnMqk--yqw | 300 | — |
| CNAME | projector.tensorflow.org | tensorflow.github.io | 300 | — |
TLS 与证书
HTTP 响应标头
| 标头 | 值 |
|---|---|
| content-type | text/html; charset=utf-8 |
| cache-control | max-age=600 |
| server | GitHub.com |
| access-control-allow-origin | * |
已识别技术
页面、搜索与分享信息
| 页面描述 | 未检测到 |
|---|---|
| 规范链接 | 未检测到 |
| 语言 | 未知(默认) |
| Twitter Card | 未检测到 |
社交分享预览
9 个字段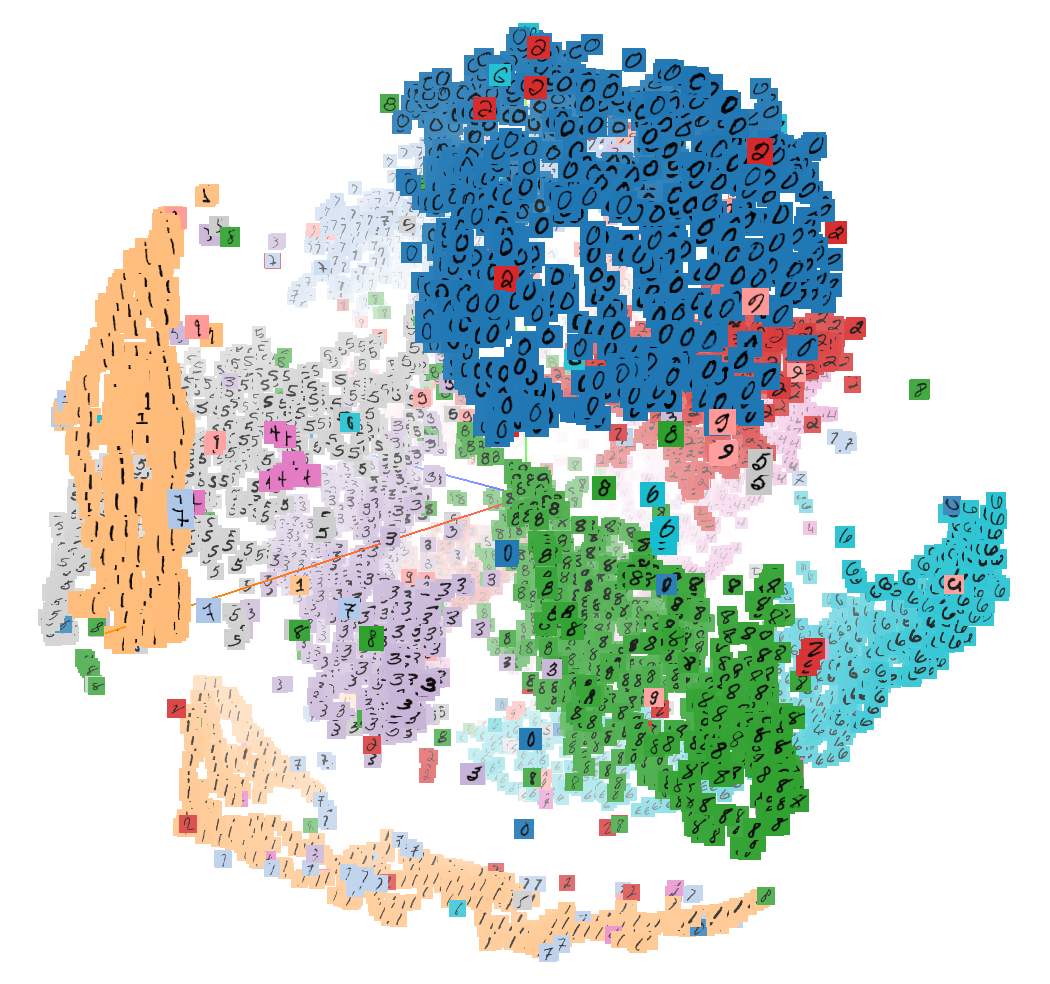

robots.txt (在新窗口打开)
HTTP 404未发现 robots.txt
Sitemaps
0暂未发现 Sitemaps
最近更新
- 网站图像资源
- 页面截图
- 网络归属信息
- 网站技术
- 页面与搜索信息
- HTTP 响应信息
- TLS 与证书
- DNS 信息
- 域名登记信息
- 网站简介
- 网站名称
- 网站资料
- 网站简介
- 网站名称
用户评价(0)